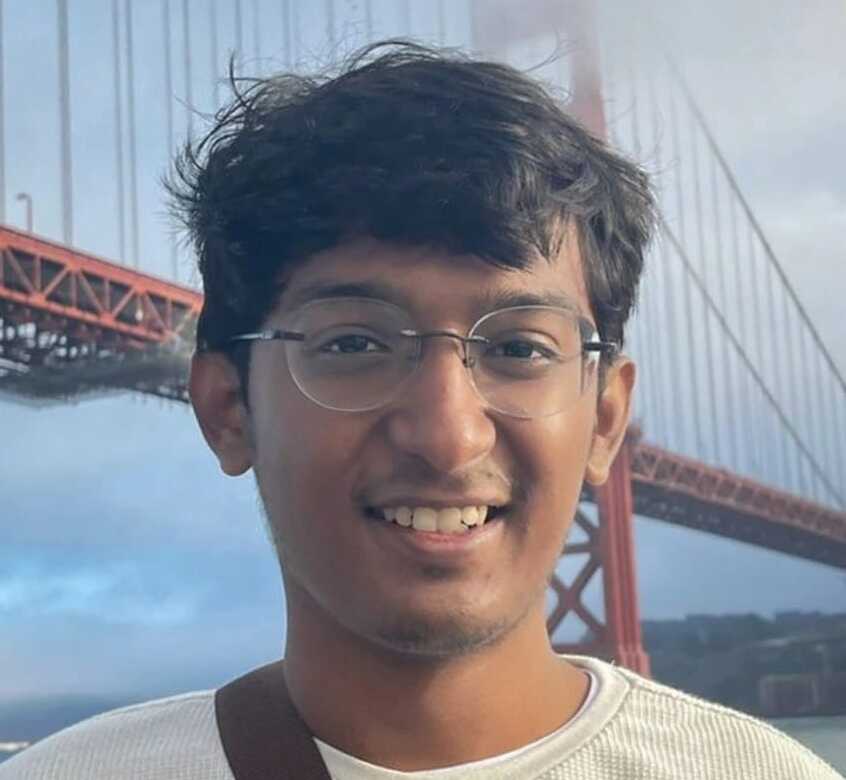
Hallo, ich bin Abhik Sarkar.
Ich bin Director of Machine Learning bei Cloudastructure Inc. Dort habe ich unsere Computer-Vision-Plattform von 100K auf 12 Millionen Videos pro Tag skaliert und kümmere mich um den On-Prem-GPU-Cluster, auf dem sie läuft.
Falls du über einen Artikel oder eine Paper-Besprechung hier gelandet bist: Hallo, das stammt von mir. Auf dieser Seite erkläre ich, was ich unterwegs lerne, von GPU-Optimierung und Transformern bis zu Video-Codecs und den Papers dahinter, meistens mit etwas zum Anklicken und Ausprobieren.
Aus dem Englischen übersetzt.
Folge mir
Einstieg
Such dir das Format aus, das dir liegt. Jedes beginnt mit einem Text, den du zuerst lesen solltest. Artikel, Konzepte und Paper-Besprechungen sind auf Englisch.
Artikel
Ausführliche Texte aus der Produktionsarbeit: GPUs, Video-Codecs und Python-Interna.
How TensorRT WorksKonzepte
Kurze interaktive Erklärungen zu ML, GPUs und Systemen, nach Themen geordnet.
Flash Attention: IO-Aware Exact AttentionPapers
Besprechungen von Machine-Learning-Papers, mit Demos, die im Browser laufen.
ViT: An Image is Worth 16x16 WordsMeine Geschichte
Was ich heute mache
Bei Cloudastructure setze ich Deep Learning und Computer Vision ein, um Sicherheit und Schutz zu verbessern. Im Alltag heißt das Python, C++, TensorRT, PyTorch, CUDA, Docker und React.js, dazu MLOps-Tooling und verteilte Systeme für Videoverarbeitung im großen Maßstab. Ich stelle außerdem das Team ein und leite es, verteilt über 11 Länder, und ich spreche über diese Arbeit auf Konferenzen.
Vorträge bei
Alle Vorträge- EuroPython
- PyCon Italia
- PyCon India
- PyCon Japan
- BangPypers
- DevFest
Warum GPUs
Ich bin zufällig Performance-Engineer geworden.
Angefangen hat es damit, dem Unternehmen Geld zu sparen. Dann habe ich gelernt, dass Decoder wie NVDEC eigenes Silizium neben den CUDA-Kernen sind. Decodierung, Vorverarbeitung und Inferenz können also gleichzeitig auf verschiedenen Teilen der GPU laufen. Sie als Pipeline zu verketten brachte uns eine 3-fache Beschleunigung und sparte im großen Maßstab Tausende an Infrastrukturkosten. Seitdem hat es mich gepackt: CUDA-Kernels, Speicherzugriffsmuster und TensorRT-Graphoptimierung, bis hinunter zur Auslastung der Streaming-Multiprozessoren.
Neben der Arbeit
Ich bin Mentor, gebe Workshops und schreibe hier, um zu teilen, was ich lerne. Abseits der Tastatur findest du mich bei Quizabenden oder beim Ausprobieren des neuesten Tools.
Was mich begeistert
- Machine Learning
- GPU-Performance-Engineering
- Softwareentwicklung
- Python
- Open Source
- Quiz
- Data Engineering
Mein Weg hierher
Ich habe über 8 Jahre Erfahrung als Machine-Learning-Engineer und Full-Stack-Entwickler. Meine Ausbildung liegt in der Informatik: ein Bachelor of Technology in Computer Science and Engineering am National Institute of Technology, Raipur, in Indien, danach Kurse auf Masterniveau in Introduction to High-Performance Computing am Indian Institute of Science, Bangalore, und CS224W: Machine Learning with Graphs über das Stanford Center for Professional Development. Die vollständige Liste steht in meinem Lebenslauf mit Nachweisen, und meine Fachgebiete zeigen, über welche Themen ich schreibe.
Artikel, die ich empfehle
Eine Auswahl von Artikeln, die mein Denken und meinen Zugang zur Technik geprägt haben.
- Making Deep Learning go Brrrr From First Principles — Horace He
- Transformers from Scratch — Brandon Rohrer
Sag Hallo
E-Mail ist der beste Weg, mich zu erreichen, egal worum es geht.
Schreib mir eine E-Mail