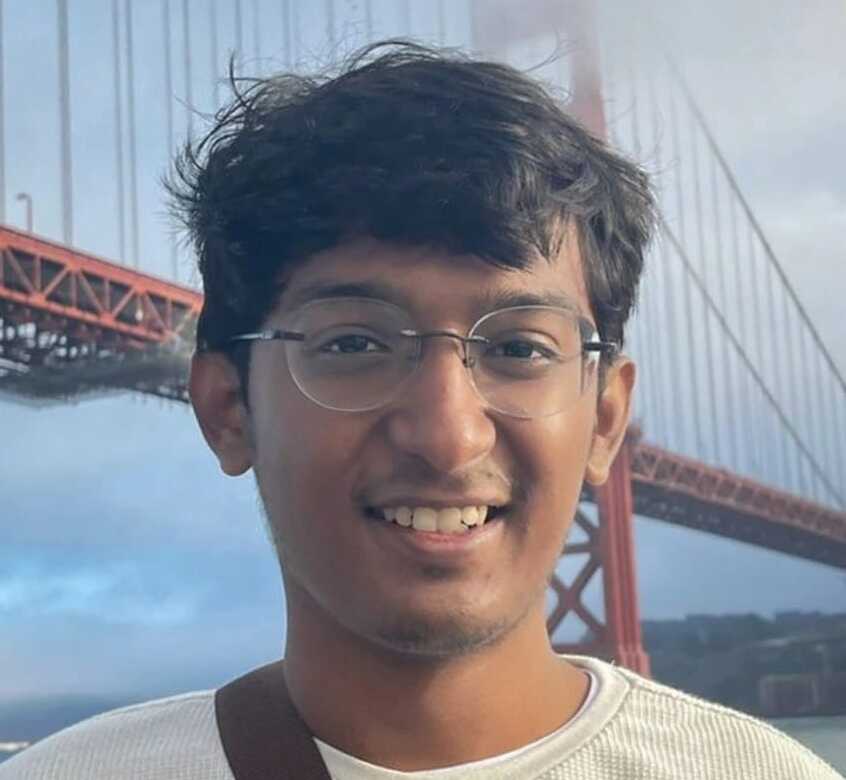
Bonjour, je suis Abhik Sarkar.
Je suis directeur du machine learning chez Cloudastructure Inc, où j’ai fait passer notre plateforme de vision par ordinateur de 100K à 12 millions de vidéos par jour, et je m’occupe du cluster GPU sur site qui la fait tourner.
Si vous arrivez d’un article ou d’une analyse de publication : bonjour, c’est moi qui l’ai écrit. Sur ce site, j’explique ce que j’apprends en chemin, de l’optimisation GPU et des transformers aux codecs vidéo et aux publications qui les sous-tendent, le plus souvent avec quelque chose que vous pouvez manipuler.
Traduit de l’anglais.
Me suivre
Par où commencer
Choisissez le format qui vous plaît. Chacun commence par une lecture à ne pas manquer. Les articles, concepts et analyses sont en anglais.
Articles
Des articles de fond tirés de mon travail en production : GPU, codecs vidéo et fonctionnement interne de Python.
How TensorRT WorksConcepts
De courtes explications interactives sur le ML, les GPU et les systèmes, classées par thème.
Flash Attention: IO-Aware Exact AttentionPublications
Des analyses de publications en machine learning, avec des démos à lancer dans le navigateur.
ViT: An Image is Worth 16x16 WordsMon histoire
Ce que je fais aujourd’hui
Chez Cloudastructure, j’utilise le deep learning et la vision par ordinateur pour améliorer la sûreté et la sécurité. Au quotidien, cela veut dire Python, C++, TensorRT, PyTorch, CUDA, Docker et React.js, plus des outils MLOps et des systèmes distribués pour le traitement vidéo à grande échelle. Je recrute et dirige aussi l’équipe, répartie dans 11 pays, et je présente ce travail lors de conférences.
Intervenant à
Toutes mes conférences- EuroPython
- PyCon Italia
- PyCon India
- PyCon Japan
- BangPypers
- DevFest
Pourquoi les GPU
Je suis devenu ingénieur performance par accident.
Tout a commencé par l’envie de faire économiser de l’argent à l’entreprise. Puis j’ai découvert que les décodeurs comme NVDEC sont des circuits distincts des cœurs CUDA : le décodage, le prétraitement et l’inférence peuvent donc tourner en même temps sur différentes parties du GPU. Les enchaîner en pipeline nous a apporté une accélération de 3x et des milliers d’économies d’infrastructure à grande échelle. Depuis, je suis accro : kernels CUDA, schémas d’accès mémoire, optimisation de graphes TensorRT, jusqu’à l’occupation des streaming multiprocessors.
En dehors du travail
Je fais du mentorat, j’anime des ateliers et j’écris ici pour partager ce que j’apprends. Loin du clavier, vous me trouverez à des quiz ou en train d’essayer le dernier outil sorti.
Ce qui me passionne
- Machine learning
- Ingénierie de la performance GPU
- Génie logiciel
- Python
- Open source
- Quiz
- Ingénierie des données
Comment j’en suis arrivé là
J’ai plus de 8 ans d’expérience en tant qu’ingénieur machine learning et développeur full-stack. Ma formation est en informatique : un Bachelor of Technology in Computer Science and Engineering du National Institute of Technology, Raipur, en Inde, suivi de cours de niveau master en Introduction to High-Performance Computing à l’Indian Institute of Science, Bangalore, et CS224W: Machine Learning with Graphs au Stanford Center for Professional Development. La liste complète figure dans mon CV et mes diplômes, et mes domaines d’expertise présentent les sujets que je traite.
Articles que je recommande
Une sélection d’articles qui ont influencé ma façon de penser et d’aborder la technologie.
- Making Deep Learning go Brrrr From First Principles — Horace He
- Transformers from Scratch — Brandon Rohrer
Écrivez-moi
L’e-mail est le meilleur moyen de me joindre, quelle qu’en soit la raison.
Envoyer un e-mail